Création du document
Une première version de cette présentation rassemble les pages des logiciels et l’exemple du contrat.
C’est le point de départ de l’histoire montrée ici.
Ressources
Des explications sur les logiciels, leurs usages et leur fonctionnement.
Dans cet exemple, le contrat est conservé dans sa première version.
109 articles
Guide technique pour l’équipe informatique : stockage S3, versions, événements, réplication et vérification des dossiers.
Un document évolue, une autorisation expire, une décision est révisée. Quelques mois plus tard, il faut retrouver les informations sur lesquelles une équipe s'était appuyée. La Memory Layer de KARL conserve les versions, leurs liens et les traces des opérations. Mais cette mémoire doit aussi traverser les incidents.
Du dossier de support au pack signé et aux tests de recette sur site : comment le client peut vérifier une correction de S3Guardian.
Comment la memory layer de KARL Core relie versions, validations et décisions pour aider les équipes à comprendre une régression et à retrouver le contexte d'un changement.
Comment une équipe d'investigation a transformé une clé USB en dossier vérifiable, et pourquoi son avocate a pu le prouver, seule, sans réseau, dix-huit mois plus tard.
Un journaliste australien assiste à la présentation de KARL à Ljubljana et en tire un compte rendu sans complaisance : architecture sans base de données, restauration en 3 secondes, et une tarification encore à écrire.
Un client conteste un refus de prêt huit mois après la décision. Répondre suppose de produire une preuve que le médiateur peut vérifier lui-même, sans avoir à croire l'organisation qui la produit.
Huit mois après avoir prolongé l'accès d'un fournisseur, un audit interne pose une question simple. Y répondre suppose de retrouver non pas l'état d'aujourd'hui, mais celui qui existait au moment de la décision.
Une entreprise croit avoir sécurisé son avenir avec des sauvegardes régulières. Le jour où elle doit vraiment changer de fournisseur, elle découvre que la sauvegarde ne suffit pas : c'est la mémoire de ses données qui doit pouvoir voyager.
Un scénario fictif montre comment un DPO traite les demandes d'accès, d'explication d'une décision automatisée et d'effacement dans KARL MX.
Un scénario de crédit illustré dans KARL MX montre comment les versions, le graphe temporel et le RAG gouverné permettent de reconstituer la décision d’ARIA dans un Evidence Pack scellé.
Un scénario d’assurance illustré dans KARL MX montre comment retrouver, grâce au versionnement, au graphe temporel et au RAG gouverné, les documents et versions consultés par NOA.
Le stockage objet fournit capacité, rétention paramétrable et accès par API. La continuité d’entreprise exige aussi de préserver l’identité des données, leur contexte et leur historique gouverné.
Dans un parcours pris en charge par KARL Core, les données, leurs transformations et les décisions qui les concernent sont reliées aux ressources dès la création des fichiers ; leur histoire est conservée au-delà des frontières d’un dépôt Git.
Après un ransomware, remettre les systèmes en service ne suffit pas : il faut encore déterminer si les données restaurées sont fiables.
Un dossier de livraison peut réunir plusieurs représentations d’un même état et les composants associés. KARL Core les décrit et distingue les copies de stockage d’une nouvelle version métier.
KARL Core distingue la ressource, son emplacement et ses sources de référence pour conserver l’historique d’un plan malgré ses déplacements et renommages.
Knowledge Layer relie les données et leurs sources ; Memory Layer conserve leur état et leur contexte dans le temps. L’article précise leurs rôles, leur complémentarité et les limites de la mémoire.
Une décision prise par un agent ne se résume pas à sa réponse. Il faut pouvoir retrouver la donnée, la règle, l'autorisation et le contexte qui l'ont rendue possible. C'est l'angle choisi par StorageNewsletter pour présenter StratoFoundry.
En 1997, un mémoire d’ingénieur à l’EPITA décrivait des objets répartis dotés de règles d’usage et de transformation, classés selon trois catégories : boîte blanche, boîte grise ou boîte noire. Vingt-neuf ans plus tard, l’idée se prolonge dans PanglotOS et ses plus de 150 services polyglottes, puis dans le projet KARL core.
La numérisation de la santé produit de grands volumes de dossiers patients, d’imagerie et de données de télémédecine. Comment en préserver l’intégrité et la disponibilité ? L’article examine les exigences RGPD, HDS et ISO 27799 et les architectures résilientes.
L’inversion de modèle peut parfois révéler des attributs privés à partir des réponses d’un modèle. Cet article décrit les mécanismes, les situations d’exposition en entreprise et les contre-mesures, dont la confidentialité différentielle.
Les systèmes d’IA prennent chaque jour des milliers de décisions. Comment en conserver les preuves sans garder indéfiniment les données sources ? L’article examine les métadonnées, les preuves cryptographiques, les explications XAI et les choix de rétention, avec leurs limites.
La directive NIS2 ne se contente plus d'exiger la mise en place de mesures de sécurité : elle impose de prouver que chaque action a été réalisée. Une chaîne de conservation fondée sur l'horodatage, le versionnage et le stockage WORM devient indispensable pour les entités essentielles et importantes.
La directive NIS2 exige de transformer chaque action de sécurité en preuve fiable, horodatée et immuable. Combiner le stockage WORM, les buckets S3 Object Lock et une chaîne de conservation cryptographique crée un pipeline complet de preuve juridiquement acceptable, indispensable lors d'audits ou d'investigations forensiques.
Les organisations accumulent chaque jour des pétaoctets de « dark data » : fichiers, courriels, journaux et bases obsolètes hors des processus de gouvernance. Cet article examine leur coût, leurs risques, les usages possibles de l’IA et les contrôles nécessaires à leur exploitation.
Les monolithes legacy écrivent leurs journaux d'audit sur disque local — la traçabilité juridique est souvent insuffisante. Migrer ces flux vers un stockage S3 avec Object Lock, versionning et SDK Rust permet de bénéficier de l'immuabilité juridique tout en réduisant les coûts d'exploitation.
Les organisations doivent non seulement sécuriser les données dans le cloud, mais prouver que chaque opération de fichier est conforme aux règles. Cet article explique comment construire une bibliothèque Rust d'audit immuable produisant une chaîne de preuves exploitable en audit.
Les services d’IA générative dans le cloud public traitent chaque jour des millions de fichiers. Au-delà de la question « le modèle peut‑il répondre correctement ? », il faut savoir où les documents sont stockés, combien de temps et à quelles fins. L’article examine les risques de confidentialité, les exigences du RGPD et de l’AI Act, et les mesures de contrôle.
Les assureurs demandent des preuves que les données critiques sont protégées et restaurables. Cet article présente leurs exigences et les architectures de protection, puis examine comment l’IA peut automatiser la surveillance, optimiser les sauvegardes et produire les éléments attendus lors d’un audit. Il se termine par un scénario pour une PME industrielle.
LTO et strip retirent les symboles inutiles des binaires Rust et réduisent leur surface d’attaque. Une compilation déterministe produit le même binaire à partir du même code source. Cet article présente les profils release et les éléments de preuve utiles lors d’un audit NIS2.
Dans les environnements critiques, détecter et diffuser une alerte en quelques microsecondes contribue à la résilience. Cet article présente un pipeline fondé sur Tokio et une chaîne de conservation immuable (horodatage qualifié, hash SHA-256, stockage WORM) pour rendre chaque événement vérifiable, conformément aux exigences de NIS2.
Une fuite ou une compromission de données sensibles peut entraîner des pertes financières, juridiques et réputationnelles. Chiffrer ces données ne suffit pas si les clés restent accessibles au même endroit. Cet article présente les principes et architectures (KMS, HSM, chiffrement à enveloppe) qui séparent données et secrets, ainsi que les enjeux de gouvernance associés.
Les capteurs, automates et systèmes embarqués génèrent chaque jour des pétaoctets de données. Pour l’IA, ces flux doivent être fiables, traçables et opposables. Cet article présente les exigences techniques, organisationnelles et réglementaires, une architecture de référence et les pratiques de gouvernance, de qualité et de sécurité, avec un cas de maintenance prédictive.
Les bibliothèques dynamiques Rust (cdylib) combinent performance et compatibilité C. Associées aux primitives cryptographiques zeroize, SHA-256 et UUID v4, elles peuvent servir à créer des plugins répondant aux exigences techniques et de traçabilité de NIS2.
Après une attaque par rançongiciel, restaurer les systèmes depuis zéro n’est pas toujours une option. NIS2 exige de pouvoir retracer les décisions, les actions et les contrôles. Cet article examine comment limiter les dommages et documenter la conformité sans réinstaller toute l’infrastructure.
Le RGPD impose des durées de conservation, mais les modèles entraînés peuvent garder des traces des données utilisées. Cet article examine les exigences juridiques, les risques techniques et opérationnels, les méthodes de machine unlearning et les pratiques permettant de concilier conformité, performance et coûts.
NIS2 exige des preuves fiables des mesures de cybersécurité. Cet article présente le plugin SSA (Secure Behavioural Alerts) écrit en Rust et explique comment l’horodatage, le versionnage et la traçabilité permettent de conserver chaque alerte comme élément de preuve lors d’un audit ou d’une investigation.
NIS2 exige des preuves irréfutables des mesures de cybersécurité. Les systèmes d’alerte doivent aussi protéger les données qu’ils traitent. Cet article décrit un plugin Rust utilisant zeroize, SHA-256 et UUID v4 pour créer des payloads confidentiels sans exposer la clé de chiffrement.
L’IA embarquée traite les données au plus près des capteurs, mais les systèmes centraux doivent aussi y accéder. L’architecture, les protocoles et les modèles de cohérence déterminent la synchronisation entre edge et cloud, avec des risques techniques, réglementaires et financiers.
La suppression du fichier source ne garantit pas l’effacement d’un document présent dans un index vectoriel, des caches ou des sauvegardes. Le RGPD, le CCPA, les risques résiduels et les coûts opérationnels doivent aussi être pris en compte.
Une chaîne de conservation complète trace, sécurise et conserve les données pendant tout leur cycle de vie. Elle soutient la fiabilité des modèles, la conformité réglementaire et la résilience, et s’articule avec DevSecOps et MLOps.
Les agents autonomes peuvent analyser, transformer et transmettre des données, mais aussi déplacer ou exposer des informations sensibles sans validation humaine. Les organisations doivent encadrer ces actions au regard de l’AI Act, du GDPR et des exigences de cybersécurité, notamment ISO 27001 et NIST.
Les organisations européennes combinent des clouds souverains et publics pour répondre aux exigences de résidence des données et profiter des économies d’échelle. Un Data Fabric hybride peut orchestrer leur réplication tout en conciliant souveraineté, performance, résilience et conformité (RGPD, NIS2).
Les LLM peuvent restituer des procédures périmées ou contradictoires avec la version officielle. La gestion du cycle de vie des contenus, le RAG et la gouvernance de l’IA aident à maintenir les réponses à jour.
Une panne ou une compromission peut interrompre ou altérer une plateforme d’IA, affecter la confiance, entraîner des coûts opérationnels importants et créer des risques juridiques. Une restauration fiable doit préserver l’intégrité des modèles, la cohérence des pipelines d’entraînement, la continuité des services et la conformité réglementaire.
Les ETI et PME doivent prouver l’intégrité, l’historique et l’auditabilité de leurs données malgré des budgets et des équipes souvent plus limités que ceux des grands comptes. L’article présente une chaîne documentaire auditable, traçable et immuable sans dépenses de plusieurs centaines de milliers d’euros.
L’EU AI Act impose progressivement aux organisations de tracer, documenter et auditer leurs usages de l’IA. Les prompts, modèles et sorties deviennent des preuves à historiser, à conserver de façon immuable et à restituer.
Avec les LLM et les services d’inférence hébergés, la capacité d’une organisation à stocker, retrouver et exploiter son patrimoine informationnel repose désormais sur un moteur d’IA propriétaire. Cette dépendance soulève des enjeux techniques, économiques, juridiques et stratégiques.
Aucune politique de sécurité n’empêche toute corruption des données. L’immutabilité évite qu’elle devienne permanente. C’est la propriété la plus sous-estimée des architectures de stockage modernes, et probablement la plus stratégique.
Challenges a consacré un article à KARL et à la place du temps dans les données : un enjeu de résilience, de conformité et de mémoire documentaire pour les entreprises.
Des données publiques ou considérées comme non sensibles peuvent, une fois croisées avec d’autres sources, révéler des profils détaillés, des secrets d’entreprise ou des informations médicales protégées. Cet article présente les mécanismes du recoupement, le cadre juridique et les contre-mesures pour aider les dirigeants, DSI et RSSI à maîtriser ce risque.
Les régulateurs, les clients et les administrateurs font de la souveraineté numérique une exigence concrète. Y répondre suppose des choix d’architecture clairs pour reprendre le contrôle des données.
La plupart des systèmes de coffre-fort numérique s’appuient sur une base de données intermédiaire qui duplique l’information. Cette architecture augmente les risques et les coûts, et limite la scalabilité. L’approche S3 native élimine cette couche intermédiaire.
Alors que les modèles d’IA deviennent des actifs stratégiques pour les entreprises, celles-ci doivent pouvoir quitter un service cloud ou une API tierce sans perdre leurs datasets, vecteurs d’embedding ni journaux d’inférence. Le droit à la portabilité prévu par le RGPD ne suffit pas : la continuité des projets IA, la confidentialité des données exportées et les coûts de migration dépendent aussi de processus techniques et contractuels. Cet article présente le cadre juridique, les actifs concernés, les architectures et outils qui facilitent la réversibilité, ainsi qu’un cas de migration d’une solution propriétaire vers un modèle open source.
Les audits modernes échouent rarement par manque de travail. Ils échouent plutôt parce que les preuves sont introuvables : documents dispersés, versions contradictoires, historique absent ou responsabilités floues.
Aucune organisation n'est totalement protégée. La question n'est plus « serons-nous attaqués ? » mais « combien de temps nous faudra-t-il pour revenir à un état sain ? ». La résilience devient l'indicateur clé de la cybersécurité.
L’IA transforme la prise de décision des organisations et crée de nouveaux types d’incidents liés aux modèles. Leur analyse exige des traces différentes de celles recueillies lors d’incidents de cybersécurité classiques. Cet article présente le cadre normatif, les artefacts à préserver, les méthodes d’acquisition et d’analyse, ainsi que les limites techniques et juridiques.
Depuis vingt ans, les entreprises s’appuient sur les sauvegardes pour protéger leurs données. Elles couvrent les pertes accidentelles, mais pas les cyberattaques, les ransomwares, la corruption silencieuse ni les exigences d’audit actuelles.
Les ordinateurs quantiques capables d’exécuter l’algorithme de Shor pourraient menacer RSA et la cryptographie à courbes elliptiques. Les organisations doivent préparer leurs KMS et leurs PKI à la cryptographie post-quantique avant 2026.
Journaliser les échanges avec un système d’IA facilite leur traçabilité et la détection des dérives, mais peut créer une base de données contenant des informations personnelles. Pseudonymisation, chiffrement et agrégation différentiellement privée aident à limiter ce risque.
Le tracing distribué peut intégrer des contrôles Zero‑Trust fondés sur des politiques d’accès contextuelles, automatisées et vérifiables. OpenTelemetry, le service mesh et des moteurs comme OPA structurent cette approche. Une plateforme de paiement multicloud illustre ses bénéfices mesurables et ses contraintes opérationnelles.
L’association de GitOps et MLOps automatise la construction, les tests et la mise en production des modèles d’IA, avec traçabilité, conformité réglementaire (RGPD, IA Act) et retour arrière immédiat.
Les images de caméras, de drones et de capteurs IoT peuvent servir de preuves en justice. Leur valeur probatoire dépend de la traçabilité de leur origine, de leur intégrité durant la conservation et du respect des exigences juridiques.
Avec NIS2, prouver ses actions dépend autant de la façon dont les données sont conservées que des données conservées. Versionnage, gestion de la temporalité et immutabilité structurent une stratégie de stockage conforme.
La prompt injection peut exploiter des documents contenant des instructions malveillantes pour détourner un LLM, modifier son comportement ou exfiltrer des données. Les défenses impliquent des mesures techniques, juridiques et opérationnelles.
La conformité NIS2 exige de prouver quelles données ont servi à chaque décision automatisée, quand elles ont été utilisées et si elles sont restées intègres. Sans souveraineté sur les corpus d’entraînement, cette démonstration devient impossible.
Les techniques de quantification, de pruning et TinyML permettent à des appareils IoT dotés de quelques dizaines de kilooctets de RAM d’exécuter des modèles d’IA. Leur gouvernance doit couvrir la conformité, la sécurité et la performance pendant tout le cycle de vie.
Lors d’une fusion-acquisition, une IA peut servir à analyser, classer ou migrer les actifs informationnels. Le mélange de bases de connaissances, de modèles ou de métadonnées peut compromettre la confidentialité, la conformité et la valeur stratégique des deux entreprises.
La piste d’audit relie identité, opération et ressources consommées. Ces données aident à expliquer les coûts de stockage, à repérer les activités qui les génèrent et à définir des règles d’attribution adaptées.
Le fine-tuning adapte un grand modèle de langue (LLM) ou un modèle de vision aux besoins d’une organisation. Il pose des questions sur les droits liés au « savoir » intégré, les risques de fuite ou de biais, ainsi que sur la gouvernance et la conformité.
Détenir des données internes ne suffit pas à autoriser leur utilisation pour entraîner une IA. Droit d’auteur, licences, contrats, RGPD et obligations de l’Artificial Intelligence Act déterminent les conditions d’usage. L’article présente les vérifications à mener avant l’entraînement.
Le data lineage suit les données depuis leur document source jusqu’à la réponse de l’IA, en retraçant les étapes d’ingestion, de transformation, de stockage, d’enrichissement, d’entraînement et d’inférence. L’article présente les enjeux de gouvernance et de conformité, les outils et un cas d’usage.
Dans une architecture d’IA générative, les « actifs de données » prennent plusieurs formes : sources, enrichissements, embeddings et réponses générées. L’article compare leurs risques pour la confidentialité, l’intégrité et la propriété intellectuelle, et présente les contrôles à mettre en place.
Les données synthétiques peuvent faciliter l’analyse et le partage tout en réduisant l’exposition des données personnelles. Leur génération ne garantit toutefois pas la confidentialité. L’article examine les méthodes, les risques d’inférence et le cadre de gouvernance.
Les agents IA dotés de droits élevés nécessitent une gouvernance claire des identités machines. L’article examine les responsabilités en cas d’incident, les risques liés aux privilèges administrateur et les mesures de contrôle et d’audit.
Ce guide explique comment intégrer l’internationalisation dans un produit web en Rust : choix des bibliothèques, gestion des traductions et étapes du développement à la production.
Les requêtes (« prompt ») et les réponses générées peuvent contenir des informations sensibles, des décisions ou des connaissances métier. L’article examine leur conservation et les critères pour choisir entre suppression rapide et archivage selon les exigences de conformité, de résilience et de valeur métier.
Après le retrait d’une application ou d’une infrastructure, certaines données restent nécessaires pour répondre aux audits et aux obligations légales, réglementaires ou contractuelles. L’article présente les catégories à conserver et les critères de choix.
Les IA génératives amènent les organisations à revoir le contrôle d’accès. Un assistant qui peut consulter toutes les ressources accessibles à un collaborateur promet des gains de productivité, mais expose aussi à des fuites de données, à des difficultés de conformité et à de nouveaux vecteurs d’attaque.
Le « référentiel » d’un modèle d’IA peut s’éloigner de la réalité opérationnelle lorsque les distributions, les comportements et les biais évoluent. Cette dérive menace la fiabilité, la conformité et la valeur des systèmes d’IA. L’article présente des méthodes de détection, une gouvernance MLOps et un cas d’usage bancaire.
Les données RH ne conviennent pas toutes au recrutement, à la gestion des talents ou à la planification de la main-d’œuvre par l’IA. Cet article examine les exigences du RGPD, les risques de discrimination et les menaces techniques, puis présente les catégories à exclure des jeux d’entraînement ou d’inférence et les mesures de gouvernance associées.
La santé, la finance et l’administration publique ont des exigences différentes en matière de confidentialité, de conformité et de résilience. Une infrastructure partagée peut créer des risques juridiques, techniques et organisationnels. L’article compare les contraintes sectorielles et présente des options d’isolation et des architectures hybrides.
Face aux menaces internes et aux exigences de conformité, un départ doit entraîner la révocation rapide des accès tout en préservant une piste d’audit fiable. L’article présente les pratiques organisationnelles, les outils IAM et les solutions d’observabilité utiles pour conserver la trace des contributions passées.
Dans les architectures cloud-native, les pods peuvent apparaître, se déplacer ou disparaître en quelques secondes, alors que les bases de données, files d’attente et autres états critiques doivent persister. L’article présente les mécanismes Kubernetes, les pratiques DevSecOps et la gouvernance nécessaires à leur protection, en conciliant sécurité, contraintes réglementaires et coûts.
Des organisations envisagent de réécrire en Rust des outils d’audit de conformité et de sécurité écrits en C pour répondre aux exigences de sûreté mémoire. À partir du cas d’un moteur d’analyse statique de configurations réseau, l’article décrit les motivations, l’architecture cible, la migration, les bénéfices mesurés et les compromis associés.
Les réglementations (GDPR, PCI DSS, NIS2 et SOX) imposent de tracer les activités informatiques. JSON et Syslog, deux standards largement adoptés, offrent des mécanismes complémentaires pour l’intégrité, la lisibilité et la conservation des pistes d’audit. L’article compare ces formats et présente une architecture de journalisation ainsi qu’un cas d’usage hybride.
L’asynchronisme de Rust peut rendre certains bugs difficiles à détecter. Cet article présente les tests unitaires et d’intégration, la simulation du temps avec Tokio et les tests fondés sur les propriétés avec proptest ou quickcheck. Il explique comment combiner ces méthodes et leurs limites, notamment les faux positifs et la charge de maintenance.
Les applications web doivent parfois servir des fichiers de plusieurs gigaoctets (vidéos, archives, images médicales ou exports de bases de données) sans saturer la mémoire du serveur. Axum, framework Rust fondé sur Tokio et Hyper, permet le streaming HTTP. L’article en décrit les mécanismes, la mise en œuvre, les compromis techniques et les enjeux de sécurité et de conformité.
Le configuration drift apparaît lorsque l’infrastructure réelle diverge de sa définition en IaC. L’article en présente les causes et les effets dans les déploiements multirégionaux, puis les moyens de le prévenir, de le détecter et de le corriger avec IaC, GitOps et policy-as-code.
Les reprises automatiques peuvent créer des doublons dans les journaux d’audit. Ce guide explique comment concevoir des API idempotentes, notamment avec des clés de requête, et présente les mécanismes de persistance et de validation nécessaires.
Le confidential computing protège les données et le code pendant leur exécution dans des enclaves matérielles. Cet article examine l’apport de Rust, notamment sa sécurité mémoire et son écosystème pour SGX, SEV et Azure, ainsi que les enjeux de performance, de maintenance et de formation.
Comparaison des algorithmes de hachage de fichiers en Rust : protocole de benchmark, performances, sécurité et choix d’implémentation pour les sauvegardes et les chaînes CI/CD.
Cet article présente l’application du Domain-Driven Design en Rust : modélisation du domaine, agrégats, dépôts et invariants exprimés par les types. Il examine aussi les bénéfices et les coûts de cette approche.
Guide d’implémentation d’un transfert de fichiers chiffré avec Tokio et rustls : architecture client-serveur, configuration TLS, gestion des erreurs et points de vigilance en production.
Comment évaluer les crates Rust : inventaire des dépendances, analyse des vulnérabilités et des risques de la chaîne logicielle, puis intégration de contrôles continus aux pipelines CI/CD.
Présentation d’un pipeline d’audit événementiel fondé sur Amazon SNS/SQS et des consommateurs Rust : acheminement des événements, sécurité, rétention, supervision et limites de l’architecture AWS.
Guide de mise en production de microservices Rust en conteneur : Dockerfile multi-stage, optimisation du build, contrôles DevSecOps, déploiement Kubernetes, sécurité et observabilité.
Le PBAC évalue les accès aux fichiers distribués selon des attributs et le contexte, au-delà des rôles statiques du RBAC. L’article présente son fonctionnement, des exemples avec OPA, Ceph et HDFS, ainsi que ses coûts et ses limites.
Les plug-in étendent une application cloud-native sans modifier ses services centraux. Cet article compare leurs modèles de déploiement sur Kubernetes et aborde les contrats, la sécurité, l’observabilité et le cycle de vie.
Les feature flags permettent d’activer ou de désactiver à la demande des dépendances lourdes comme ONNX. Cet article présente leur intégration, ainsi que les choix d’architecture, de sécurité et de gouvernance en production.
Depuis 2017, WebAssembly permet d’exécuter du code dans le navigateur. Cet article examine l’intégration de modules Rust compilés en Wasm avec JavaScript, les gains attendus, les contraintes de sécurité et les choix d’architecture.
Tokio et Hyper permettent de bâtir un service asynchrone de conversion de documents. Cet article en présente l’architecture, la gestion des flux et du parallélisme, ainsi que les enjeux de sécurité, de coût et d’exploitation.
Avec clap et Tokio, une CLI Rust peut combiner analyse déclarative des arguments et sous-commandes asynchrones. Cet article examine les choix d’architecture, les mécanismes de reprise et leurs limites.
Cet article présente l’inférence d’images avec ONNX Runtime en Rust, de l’architecture du pipeline à l’utilisation des accélérateurs, et examine les contraintes de performance, de mémoire et de déploiement.
Ce guide décrit un pipeline Rust qui lit des fichiers CSV ou XLSX dans une archive ZIP et les écrit en Parquet avec calamine, zip et parquet-rust. Il aborde aussi la gouvernance des données et le déploiement cloud ou on-premise.
Le tracing relie les événements d’une application distribuée à travers ses services. Cet article présente les outils Rust, l’instrumentation, les enjeux de performance et de sécurité, ainsi que les choix d’intégration.
Le zero-copy vise à réduire les copies de buffers entre interfaces web et workers Rust. Cet article décrit les mécanismes disponibles, les contraintes d’architecture et les critères pour décider si cette approche convient à un projet.
Axum et Tokio permettent d’assembler des modules front-end dans une architecture modulaire. Cet article présente plusieurs patterns de conception et leurs effets sur le déploiement, la sécurité et l’exploitation.
Aucun article ne correspond. Essayez un autre mot ou une autre thématique.
Exemple d’historique appliqué à cette page.
Une première version de cette présentation rassemble les pages des logiciels et l’exemple du contrat.
C’est le point de départ de l’histoire montrée ici.
Sept situations expliquent comment retrouver un document, préparer un audit ou examiner une décision.
Chaque exemple présente les informations retrouvées et leur utilisation dans votre travail.
Le contrat dispose de cinq étapes que l’on peut parcourir par balayage ou avec les boutons.
Un geste vertical sur le document laisse la page défiler normalement.
Les pages de présentation utilisent des mots plus courants.
La comparaison ci-dessous reprend la phrase d’accueil avant et après ce changement.
Avant
KARL Core conserve les versions de vos documents et les décisions enregistrées. Un logiciel pour les entreprises, installé sur vos serveurs.
Après
KARL Core est un logiciel pour votre entreprise. Il garde les versions de vos documents et les accords enregistrés, pour retrouver ce qui a changé.
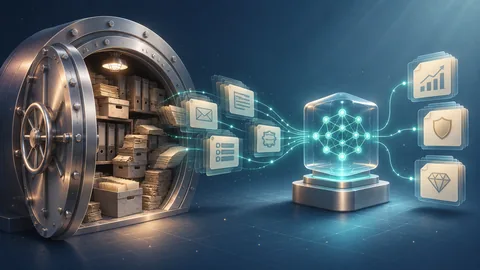
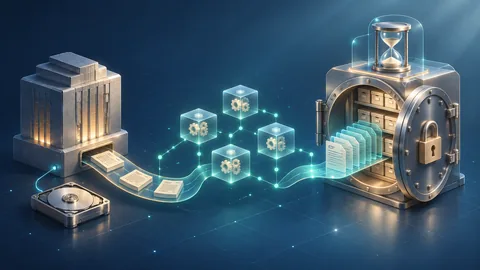
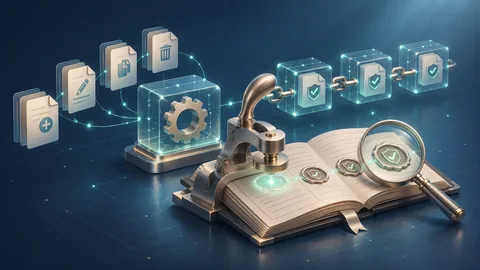
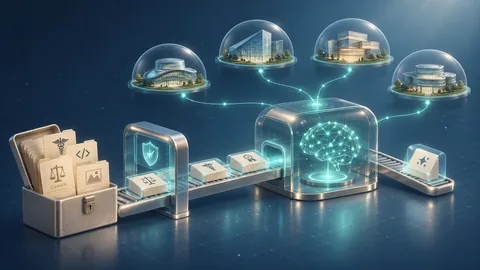
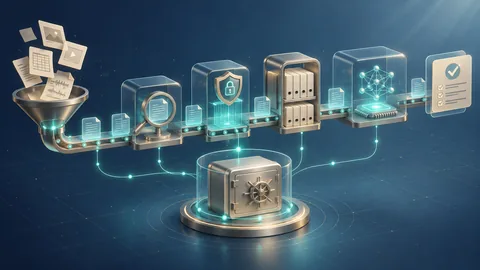
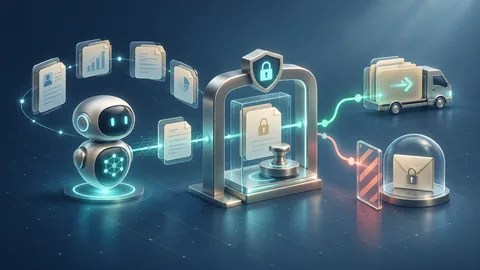
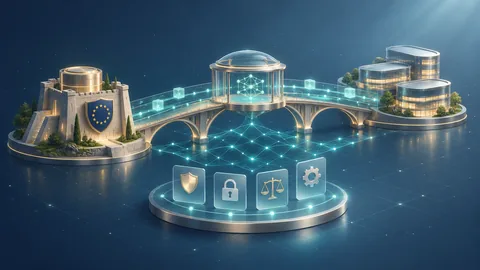
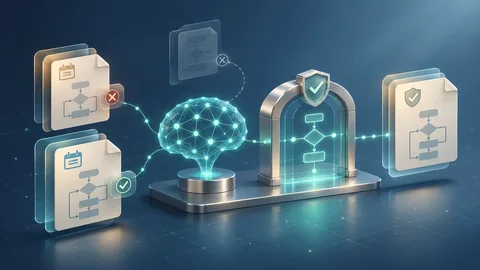
Des illustrations présentent les niveaux, les versions et les liens entre les documents.
Elles accompagnent les explications de cette prévisualisation.
Une première version de cette présentation rassemble les pages des logiciels et l’exemple du contrat.
C’est le point de départ de l’histoire montrée ici.
Sept situations expliquent comment retrouver un document, préparer un audit ou examiner une décision.
Chaque exemple présente les informations retrouvées et leur utilisation dans votre travail.
Le contrat dispose de cinq étapes que l’on peut parcourir par balayage ou avec les boutons.
Un geste vertical sur le document laisse la page défiler normalement.
Les pages de présentation utilisent des mots plus courants.
La comparaison ci-dessous reprend la phrase d’accueil avant et après ce changement.
Avant
KARL Core conserve les versions de vos documents et les décisions enregistrées. Un logiciel pour les entreprises, installé sur vos serveurs.
Après
KARL Core est un logiciel pour votre entreprise. Il garde les versions de vos documents et les accords enregistrés, pour retrouver ce qui a changé.
Des illustrations présentent les niveaux, les versions et les liens entre les documents.
Elles accompagnent les explications de cette prévisualisation.
Exemple d’historique appliqué à cette page.